n8n活用 RAGを構築して社内FAQ検索を改善してみた

 こんにちは、Cake.jp 技術部の釘野です。


 昨今のAIの進化は目覚ましく「とりあえずAIを使って業務を楽にできないか?」と考える場面も増えてきました。


 Cake.jpでも、技術部を始め社内のさまざまな業務でAI活用を模索しています。

 今回はそんな中での「カスタマーサポート業務のFAQ検索を改善した取り組み」の話をさせていただきます。


カスタマーサポートが抱えていた課題 

 Cake.jpのカスタマーサポートでは、お問い合わせに対して

  1. 内容を確認
  2. 適切なFAQを探す
  3. FAQをもとに回答を作成

 という流れで対応しています。

 ただ、Cake.jpのサービス運営期間が長くなるにつれ、FAQの数も増え続けてきました。

 結果として

  • FAQが多く、検索に時間がかかる
  • 慣れたスタッフでも毎回探すのが大変
  • 新しいスタッフには特にハードルが高い

 そんな状況がボトルネックになってきました。


そうだ、AIを使おう

 この課題に対して「FAQ検索そのものをAIに任せられないか?」という対策案があがりました。


 そこで採用したのがRAG(Retrieval-Augmented Generation:検索拡張生成)という仕組みです。

 RAGをざっくり説明すると、

「あらかじめ用意した外部データ(FAQや社内ドキュメント)を検索させ、その結果をもとにAIが回答を生成する」

 という仕組みになります。


 LLMが普段おこなっている一般知識での回答はなく「こちらが用意した限定した情報を参照して答えさせる」のがポイントです。

 カスタマーサポートのFAQ検索は、まさにRAGの活用例として良いケースとなりえると思いました。


n8nでRAGを構築する

 今回の実装には『n8n』を利用しました。

 n8nは、ノードと呼ばれる単位を組み合わせてワークフローを構築できる自動化ツールで、AI関連のノードも豊富に用意されています。


 最初に作ったワークフローは、以下のような最低限の構成です。

  • FAQデータ(CSV)をアップロード
  • ベクターDBに登録
  • 質問文からFAQを検索


 使っているノードは次のとおりです。

ラベル

ノードの種類

役割

FAQデータCSVをアップロード

n8n Form Trigger

CSVファイルをアップロードするフォームの提供。このノードを使ってCSVファイルを入力します。

FAQデータの入力

Simple Vector Store

ベクターDBへのデータの入力をします。

Embeddings OpenAI

Embeddings OpenAI

ベクターDBでのデータの入力や検索を司るAIです。今回はOpenAIの「text-embedding-3-large」モデルを選択しました。

CSV

Default Data Loader

ベクターDBへ入力するデータの形式を指定します。今回は「CSVファイル」をそのまま取り込めむようにしました。

FAQデータの検索

Simple Vector Store

ベクターDBでFAQを検索して回答をします。


 FAQデータ(CSV)は以下の3項目で、現在使われているFAQページから作りました。

  • タイトル(質問)
  • コンテンツ(回答)
  • 該当ページのURL


しかし、検索精度が思ったほど出ない

 さっそく「もらったはずのクーポンがありません」という問い合わせで検索してみたところ、返ってきたのは

  • 配送状況がわかる送り状番号を知りたい
  • eGiftの受け取りURLを紛失した

 など、大きくズレたFAQでした。


 クーポン関連のFAQは確かに入力して、登録されているのに、うまく回答されなかったのです。

 原因を考えたところ

「入力されたFAQの文章では、AIが検索しやすい形になっていない」

 ということだと推測されました。


 そこでCSVの入力をそのまま登録するのではなく「AIが検索しやすい形に要約してからベクターDBに登録する」ことにしました。

 具体的には、次のようにワークフローを拡張しました。


 追加したノードや変更したノードは次のとおりです。

ラベル

ノードの種類

役割

JSONに置換

Extract from File

以降のノードで使いやすいように、CSVファイルのデータをJSONに変換します。

FAQの要約

AI Agent

入力されたデータを要約します。プロンプトは後述。

OpenAI Chat Model

OpenAI Chat Model

FAQの文章の要約に使っているAIです。今回はOpenAIの「gpt-5-mini」モデルを選択しました。

JSON

Default Data Loader

ベクターDBへ入力するデータの形式を指定します。「CSV」から「JSON」に変更しました。
ここで要約されたFAQの文章を「pageContent」として、もとのFQAの文章を「Metadata」として登録することを指定しています。


改善後の検索結果

 再度「もらったはずのクーポンがありません」という問い合わせでで検索してみると

  • 届いたクーポンがマイページに表示されない
  • クーポンを使用することができない

 といった、質問の意図に合ったFAQが返ってくるようになりました。


 n8nから返す結果としては「Metadata」に保存した元のFAQの文章を利用するため、 スタッフが見る情報はこれまでと変わりません。

 そのうえで「探す時間」を大きく減らすことができました。


さいごに

 今回の取り組みで、

  • RAGはカスタマーサポートと相性が良い
  • データの前処理(要約)が検索精度に大きく影響する
  • n8nを使えば、比較的低コストで試せる

 ということを感じました。


 今後の課題としては、

  • FAQデータの更新を手動ではなく自動化したい。
  • 実運用の中でプロンプトや要約精度を改善していきたい。

 などを考えています。


 これからも、こうした新しい技術を取り入れながら、改善を積み重ねて日々の業務やサービスの品質向上に取り組んで行きたいと思います。

プルリクエストを小分けして、コードレビューを推進する

 こんにちは、Cake.jp 技術部 釘野です。


 皆さん、コードレビューしていますか?

 レビューの時間がなかなか取れず、ロジックの確認が大変、とか感じていませんか?


 Cake.jp技術部では、改修のリリースにあたり、コードレビューを必須としています。

 最近では、プルリクエストを分割して、小さい単位でレビュー依頼をする形式を推奨しています。


弊社のレビュー文化の歩み

 前提として、弊社エンジニアチームではレビューに対して、いくつもの変遷がありました。

  • 【最初期】単一テスト環境

 テスト環境が1つしかありませんでした。

 チーム内で声かけしながら、テスト環境にデプロイし、動作確認をしていました。

 実際にシステムを動かしながら、改修の要件を満たしているか検証して、レビューとしていました。


  • 【過渡期】GitHubのプルリクエスト機能の利用開始

 ビッグバンリリースがあった! 

 機能改修ごとにプルリクエストとテスト環境を作り、動作確認をしていました。

 改修したコードが要件を満たせているか目視で確認しつつ、レビューしていました。

 ただし、機能によってはコードの修正量が1万行を超えるプルリクエストもありました。

 そういうときは、最初期と変わらず、実際にシステムを動かしながら、改修の要件を満たしているか検証して、レビューとしていました。


  • 【現在】小分けプルリクエストの推奨

 小さいリリースの実践。

 コードの修正量が50〜200行のプルリクエストが多くなりました。

 動作確認は実装者が担保し、レビュアーにはコードレビューをメインに確認してもらっています。


小分けプルリクエストとは

 1つの機能改修にあたって、作業の目的ごとにわけて複数のプルリクエストを作ります。


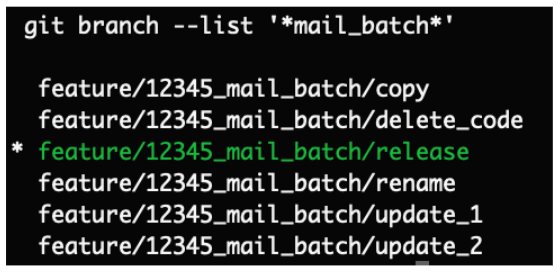
【例】既存のメールバッチをコピーして新規メールバッチを作る場合

 最初にメインブランチから、子ブランチとして、リリース用のブランチを作ります。

 リリース用のブランチから、作業ごとに小分けして、孫ブランチとして分割します。

 例えば、既存機能のコピー、リネーム、不要部分の削除、既存メールとの差分改修、テストケースの追加などによってブランチを小分けにします。


 この孫ブランチごとにプルリクエストを作ることで、小分けプルリクエストになります。

小分けプルリクエストのメリット

  • それぞれのプルリクエストでレビューすべき項目がシンプルになります。
  • 改修内容、各コードの目的がわかりやすくなります。
  • レビューにかかる時間が短くなり、レビューする人の負担が減ります。
  • 修正を破棄する場合の出戻りが小さくなります。


 実際にチームで小分けプルリクエストが浸透してきて、次のようなメリットも感じました。

  • コーディングの仕方に関する議論が活発になりました。
  • 重点的にコードレビューで見て欲しい部分がわかりやすくなりました。


 例えば「MailBatch.phpをコピーしてNewMailBatch.phpを作成」と「NewMailBatch.phpを要件に合わせて修正」をわけることで、前者よりも後者の方を重視してレビューを依頼できます。

 さらに修正のプルリクエストも「送信対象を取得するロジックの修正」「送信先を決めるロジックの修正」といった目的ごとにわけることで、修正内容が明確になります。


小分けプルリクエストのデメリットと対策

 もちろん、良い面だけではなく、デメリットもあります。

 レビューする範囲が小さくなることで、改修範囲全体の見通しが悪くなります。

 そのため、改修の要件不足やシステムのデグレードなどの発見が遅れることがあります。


 Cake.jp技術部では、それらデメリットに対して、次のような対策を講じています。

  • 事前に全体の設計、実装方法のレビューをする。
  • 修正するコードに対応するテストコードを漏れなく追加する。
  • リリース前の最終チェック(動作確認、受け入れチェックなど)を厚くする。


さいごに

 コードレビューは大変です。

 けれど、大変なものこそ分割することで対応しやすくなります。


 プルリクエストの小分けを推奨した結果、次のような実感を得ています。

  • レビューが楽になった。
  • 実装者は、コードを小さく分けることを考えるようになり、コードごとの意図や責務がより明確になった。
  • チーム内でコーディングに対する知見の共有をするきっかけが増えた。


 何事も急に大きく変更をするというのは、難しいです。

 ただ、やっていることを小さく分けて対応するように変えるのは、比較的実施できるケースが多いのではないかと感じました。


 今後もよりよい開発業務のため、小さな改善からコツコツやっていきたいと思います。


🍰 Dify APIで実現!Cake.jpにおける生成AIで商品説明文自動生成の舞台裏

1. はじめに:生成AIが変えるEC体験

ECサイトにおいて、商品説明文は「購買意欲を高める最後の一押し」にもなる重要な要素です。しかし、その作成は出店者にとって大きな負担となっています。    とくにCake.jpのようなスイーツ専門モールでは、商品の魅力を伝えることは非常に重要であり、より効果的にアピールする方法を模索している店舗さまも少なくありません。

そんな課題を解決するために、今回私たちは生成AI(Dify API)を活用して、商品説明文の自動生成機能を開発・導入しました。

本記事では、その実装背景から技術構成、プロンプト設計、そして今後の展望までを余すことなくご紹介します。

2. プロジェクト背景:手間と表現力の壁を越えるために

Cake.jpでは、出店者が自ら商品情報を入力する「店舗向け管理画面」を提供しています。   しかし、その中でとくに負担になっていたのが「商品説明文の入力」。

  • 商品自体は素晴らしいのに、うまく言語化できない…
  • 毎回説明文を考えるのが面倒…
  • 他商品との差別化がうまくできない…
  • 普段の業務に追われ、時間がなくて書けない...

こうした課題を感じていたため、「少ない労力で最大限に商品の魅力を伝える仕組み」の必要性が明確でした。

3. なぜDifyを選んだのか?

もともと社内では他業務でもDifyを利用しており、以下の理由から導入はスムーズでした

  • ドキュメントが充実しており、学習コストが低い
  • ホスティング不要ですぐに試せる
  • Flowベースで簡単にプロンプト設計できる
  • 他のLangChain系などと比べ、とにかく導入が早い!

PoC的に試すには最適な選択肢でした。

1時間で Dify APIを使ったプロトタイプを作成

バックエンド側での技術検証のために、まずはDifyのAPIを叩くプロトタイプを作成しました。 これはVS Code と Copilot を使い、1時間足らずで動くところまで作成できました。
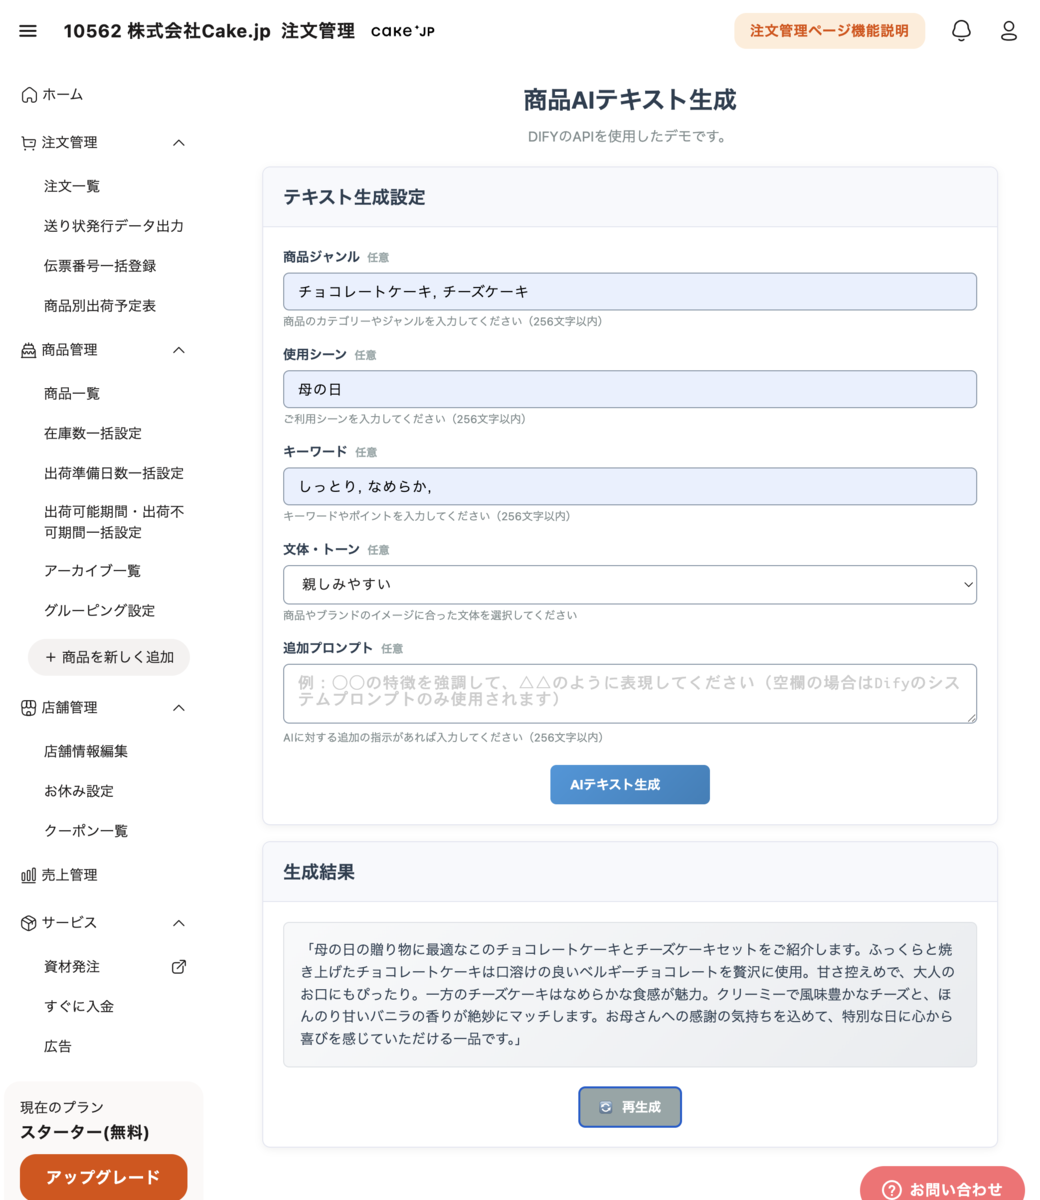
スクリーンショットの右側カラムのUI部分について、実装者は一切コードを書いていません。 js部分もすべてAIエージェントに丸投げです。

実際のプロンプト

次のcontrollerを作ってください。CakePHP1.3 PHP8.3です。
必要であれば、フロントのctpやjsもお願いします。

DifyのAPIを使ったテキスト生成機能です。
ジャンルやシーンといった情報をPHPから渡し、テキストを生成します。
フロントはjsでcontrollerのエンドポイントをAjaxでたたきます。
ページには下記のフォームが必要です。
- ジャンル(genre)
- シーン(scene)
- キーワード(keyword)
- トーン(tone)

コントローラーの名前はDifyに依存しないでください。別のAPIに変わる可能性もあります。

Difyのエンドポイント
@https://api.dify.ai/v1/chat-messages 

このあと何度か修正指示を出してはいます。

 4. 実装:CakePHP での生成AIの現場活用

プロトタイプにより実際のシステムでも使えるイメージがついたので、本番用に組み込むこととなりました。

🔌 全体構成の概要

Cake.jpはCakePHPフレームワークを中心に構築されており、店舗さま向け管理画面にて、商品情報を登録・編集できるUIを提供しています。

生成AIによる商品説明文生成機能は、以下のような構成で実現しています。
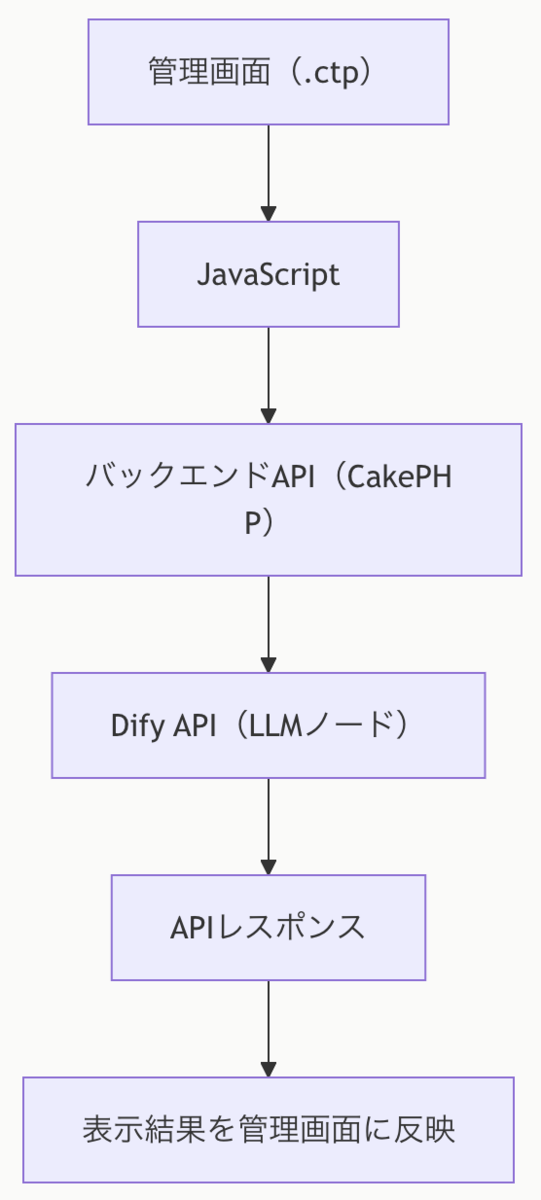
APIにリクエスト

APIにはCurlでこんな感じでリクエストしています。

...
// リクエストデータ
        $postData = [
            'inputs' => [
                'genre'   => $params->genre, // 👈ジャンル(カテゴリ)
                'scene'   => $params->scene, // 👈シーン
                'keyword' => $params->keyword, // 👈キーワード
                'tone'    => $params->tone // 👈トーン
            ],
            'query'         => $prompt,
            'response_mode' => 'blocking',
            'user'          => $params->user, // 👈店舗さまを識別するID
        ];

        $httpRequest = $this->httpClient;

        try {
            $httpRequest->init($this->config->apiUrl);
            $httpRequest->setOption(CURLOPT_POST, true);
            $httpRequest->setOption(CURLOPT_POSTFIELDS, json_encode($postData));
            $httpRequest->setOption(CURLOPT_RETURNTRANSFER, true);
            $httpRequest->setOption(CURLOPT_TIMEOUT, $this->config->timeout);
            $httpRequest->setOption(CURLOPT_HTTPHEADER, [
                'Authorization: Bearer ' . $this->config->apiKey,
                'Content-Type: application/json',
            ]);

            $response  = $httpRequest->execute();
            $httpCode  = $httpRequest->responseCode();
            $curlError = $httpRequest->errorString();
...

userというパラメータに店舗さまの識別情報を渡すことで、店舗ごとにどのくらいご利用いただいているかをDifyのコンソールで見られるようにしています。
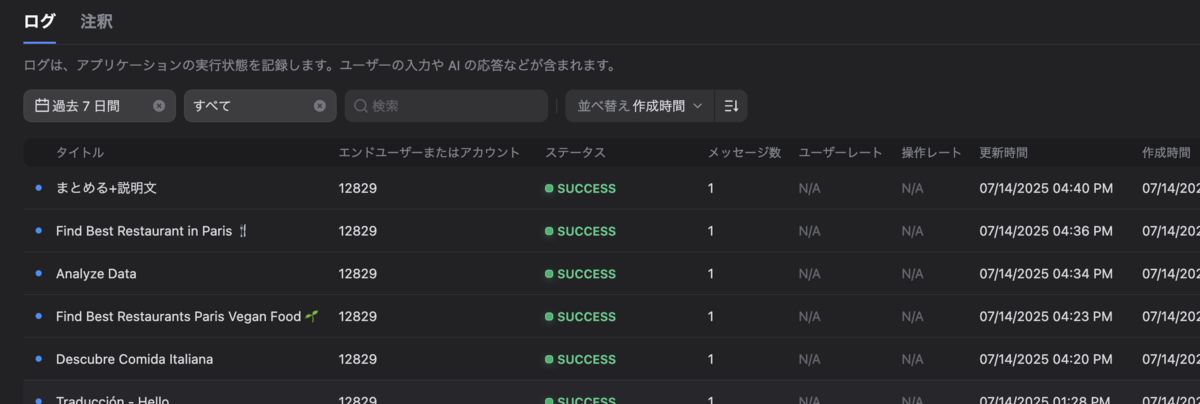
Dify側のフロー

Dify側のアプリのフローはいたって単純です。
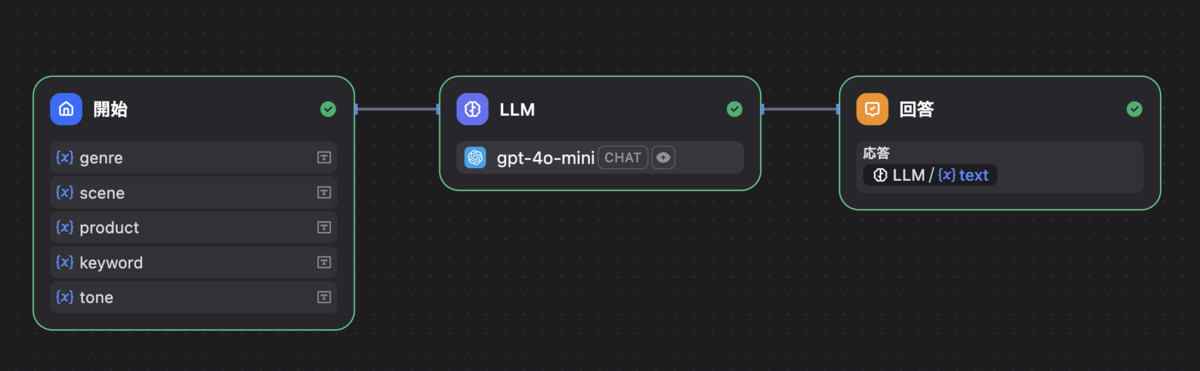
  1. 送信されてきたinputs内のパラメータをstringの変数として受け取り、
  2. LLMブロック(ノード)にてプロンプトに埋め込みリクエスト
  3. 生成されたものをJson文字列で返す

🧾 Structured outputs(構造化出力)の活用

今回の説明文の生成では、構造化出力(Structured outputs) 機能を活用しています。

Structured Outputs とは、その名の通り「構造化された出力」です。 簡単に言うと、LLMが返す結果を必ずjsonフォーマットで返す ようにできるということです。

LLMは、その仕組み上、出力が完了するまで何が返ってくるか予測できないという特性があります。そのため、従来は決まった形式での結果を確実に受け取ることが困難でした。

たとえば、 「必ずjson形式で回答してください。それ以外の回答はしなくてよいです」 といったプロンプトで、強目に出力形式をお願いしたり、JSONモードを使ったりして、jsonのフォーマットで返ってくることを願うしかありませんでした。

しかし、OpenAIが開発したこのStructured outputsの仕組みを使えば、指定したJSON Schemaに完全準拠した形で返してくれます。 (Claude や Gemini など他社のLLMでも同様のJsonスキーマ準拠のアウトプットの仕組みや概念はあるようです)

参考)https://platform.openai.com/docs/guides/structured-outputs?api-mode=responses
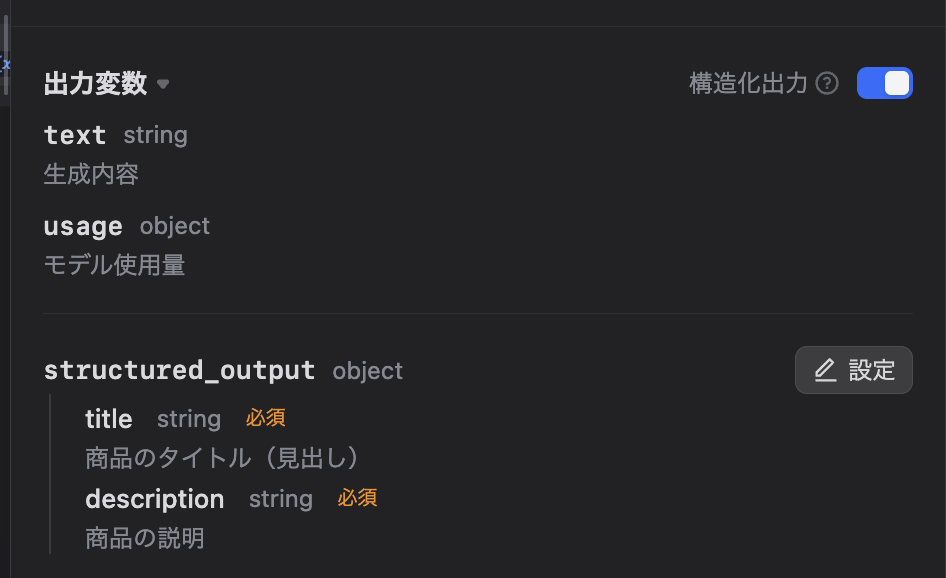
☝️Difyでは構造化出力の機能のON/OFFスイッチがある

Dify APIのレスポンス自体は元々JSONで返ってくるのですが、LLMが生成したテキスト結果は、textというプロパティに文字列で埋め込まれます。

この部分をJSON文字列にするために、構造化出力機能を使っています。

モデルによって違う、構造化出力を【 使える / 使えない】

構造化出力は、すべてのモデルで使えるわけではありません。 - gpt-4o / gpt-4o-mini は構造化出力に正式対応 - gpt-3.5-turbo などは未対応(Dify側でプロンプトにてjson出力指示を加えるフォールバックがあるそう)

Cake.jpでは、将来的には商品説明文だけでなく、タイトルやその他複数の要素を一括生成するニーズがあるため、構造化出力は重要な技術基盤になります。

🤖 gpt-4o-mini のモデルを採用した理由

私たちは「魅力的で高精度な出力をレスポンス早く」を求めて、開発初期は gpt-4o を用いてプロトタイプを作成していました。 しかし、商用運用を見据えると実行コストが懸念事項となってきました。

💰 モデルごとのDifyでのクレジットコスト

モデル名               1リクエストあたりのクレジット
gpt-3.5-turbo         1クレジット                  
gpt-4o-mini           1クレジット                  
gpt-4.1-mini           1クレジット                  
o3-mini / o4-mini     5クレジット                  
gpt-4.1               5クレジット                  
gpt-4o                 10クレジット                
gpt-4                 20クレジット                

gpt-4o-mini は gpt-4o のわずか1/10のコストなので、十分に使える品質さえ得られれば採用したいと思い、検証することにしました。

Dify プロプランの上限

現在契約中のプロプランでは、1ヶ月あたり5000メッセージクレジットが上限となります。 つまり、10クレジット消費するgpt-4oでは、1ヶ月に500メッセージしか送れません。 さらに、開発検証で既に多くのクレジットを消費してしまい、当月の残りは1000メッセージクレジットとなっていました笑

もちろん、オーバーした場合はLLMの外部APIキーを設定していれば上限を超えることは可能です。

しかし、このアプリ以外でもDifyを利用しているため、一旦5000メッセージクレジットの範囲内で収めることを目標としました。

結果的に  「そこそこ良い品質が、レスポンスよく、かつ安価で得られる」 と判断し、本番環境でも1クレジット消費の gpt-4o-mini を採用しました。

🧠 今後の構想:LLMを役割分担させる

現在は1つのLLMブロックのみですが、さらに出力の精度や品質を上げるために、LLMブロックを2つ繋げる構成も検討中です。

  1. 初稿作成用 LLMブロック
  2. 評価・修正・校正用 LLMブロック

どちらのブロックも1クレジットコストのLLMですが、役割を変えて2つ、ないしは複数を繋げることでより良い出力を得られることが予想されます。 【10クレジットの高レベルLLM1回】より、【1クレジットの下位レベルLLM x 2】 の方が高品質になる可能性もあるからです。

これはAIエージェントのデザインパターン「Agentic Design Patterns」でも語られる Reflection(自己改善) の実装にも通じる発想ですね。

 参考)「Agentic Design Patterns」 https://zenn.dev/loglass/articles/b9ee37737deb85

5. ウィザード式モーダルUIと生成AIならではのUX

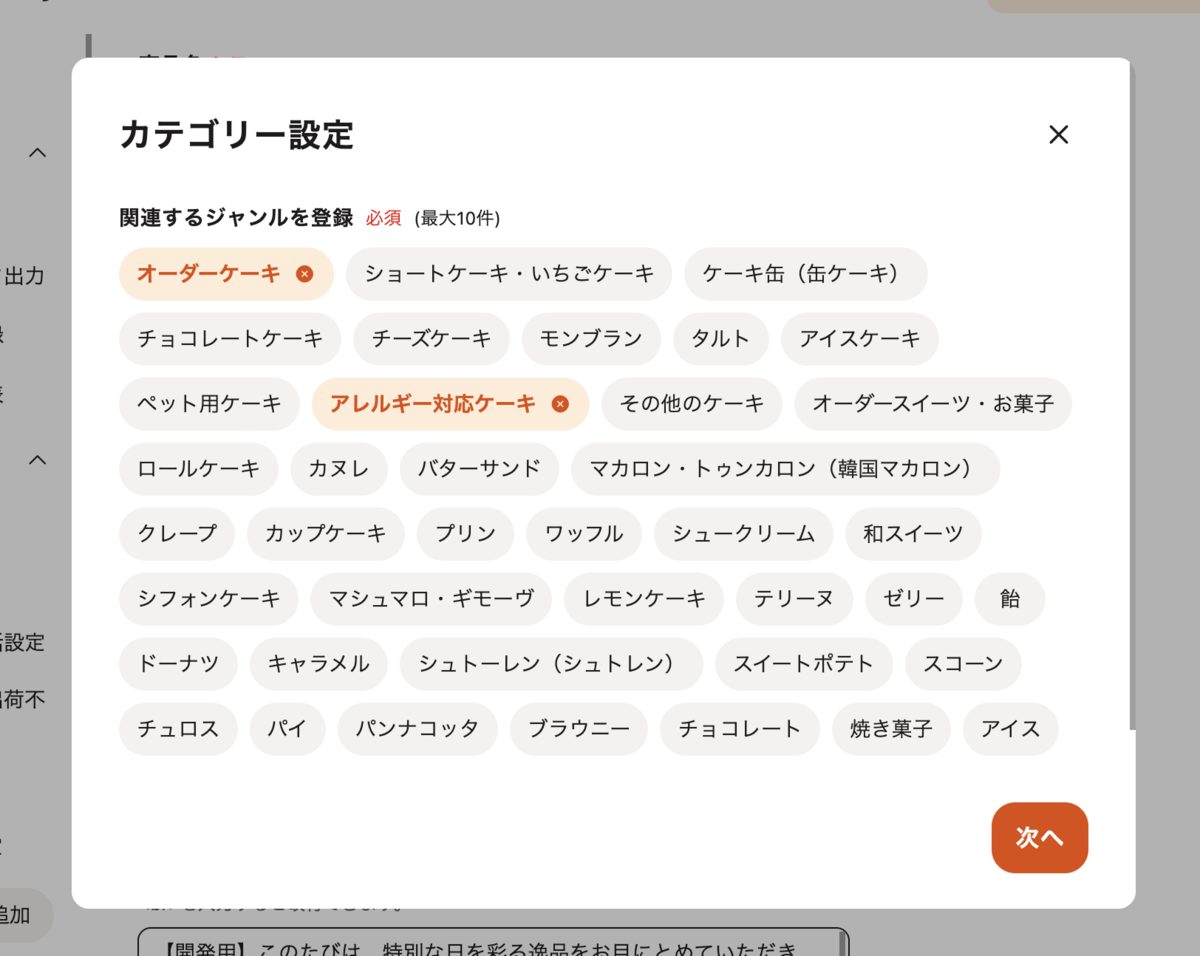
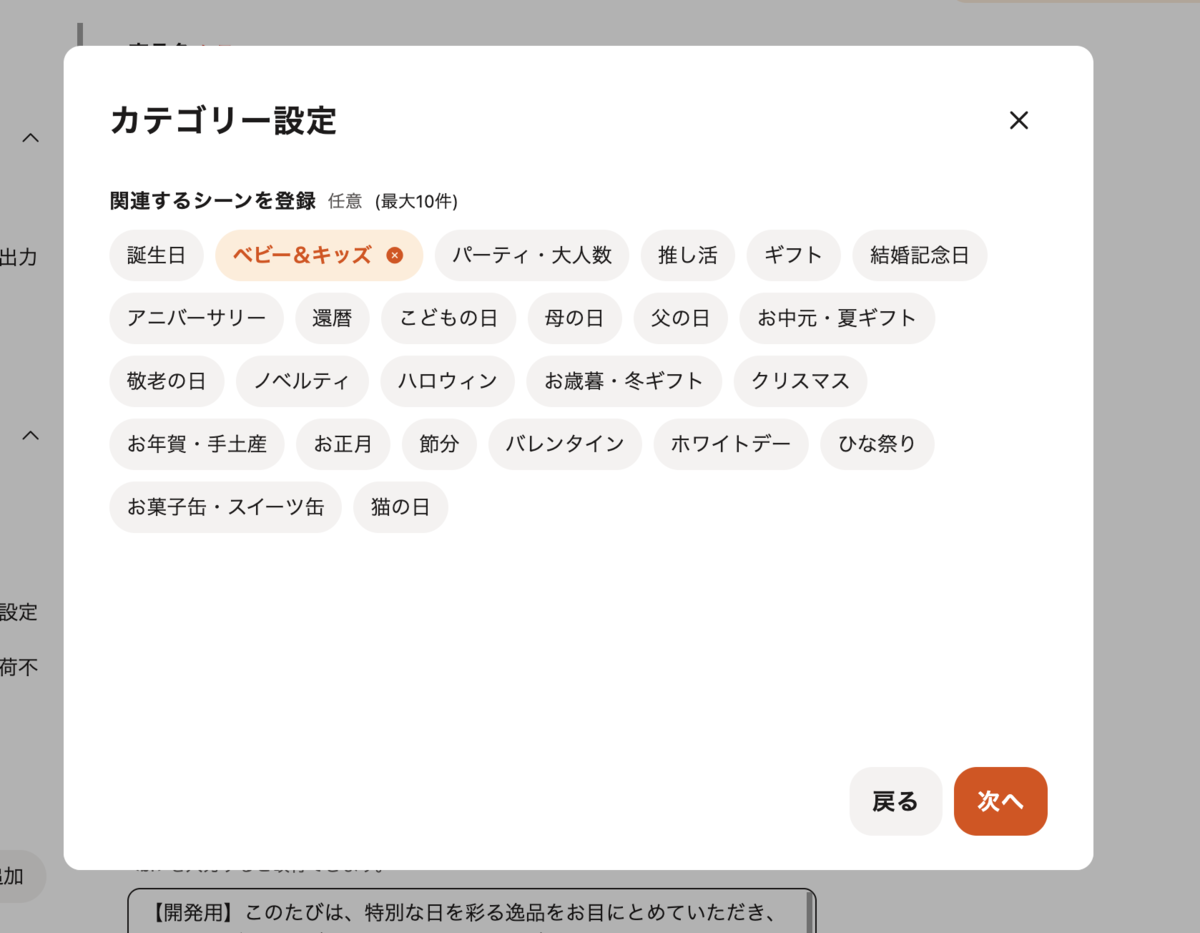
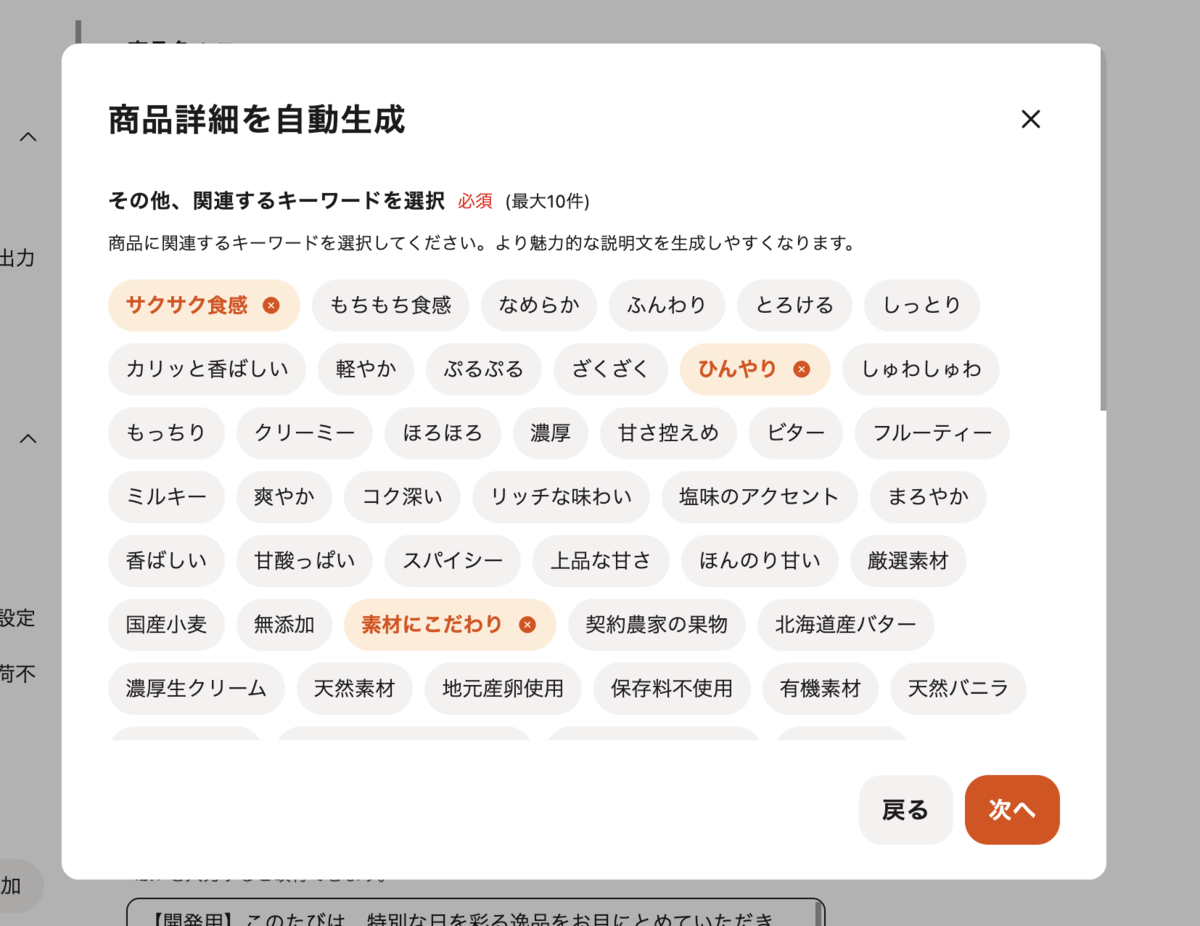
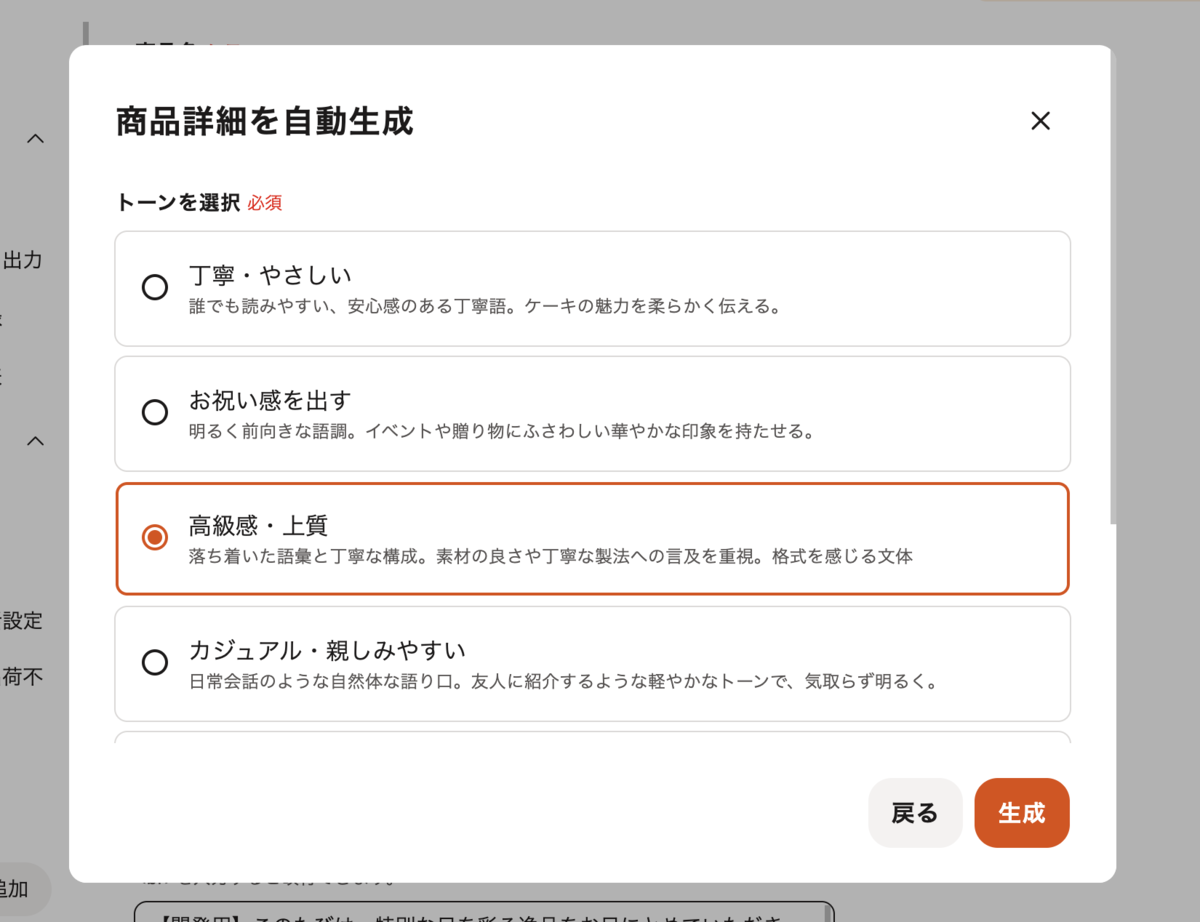
UIはモーダル形式のウィザードで構成し、以下の情報を店舗さまに順々に選択してもらうことにしました。

  • 商品ジャンル カテゴリ(例:チーズケーキ、クッキー)
  • 利用シーン(例:誕生日、クリスマス、ギフト)
  • 商品に関わるキーワード(例:手作り、無添加、さくさく)
  • 文章のトーン(例:高級感、カジュアル、お祝い感)

1画面1イシューでユーザーの認知負荷を下げるUX

 Cake.jpでは現在、店舗さまがご利用になる管理画面のUX改善のために、UIリニューアルプロジェクトが進行中です。

商品情報を入れてもらう際に1画面1イシューとするウィザード形式のUIを採用しました。

その理由は次のとおりです。

認知負荷を下げる 余計な選択肢を減らし、目の前のタスクだけに集中してもらうためです。 どれを選べば良いか?なにをすべきか?などの迷いを取り除くことができます。

意図の明確化 画面をシンプルにすることで、ユーザーが何のために行なっているかに集中でき、よりよい判断を引き出すことができます。

操作の正確性とスピード 結果として操作ミスが減り、完了までのスピードも上がります。

こうして、モーダル内で次々と段階的に商品に関する情報を選択してもらい、DifyのAPIに送信します。

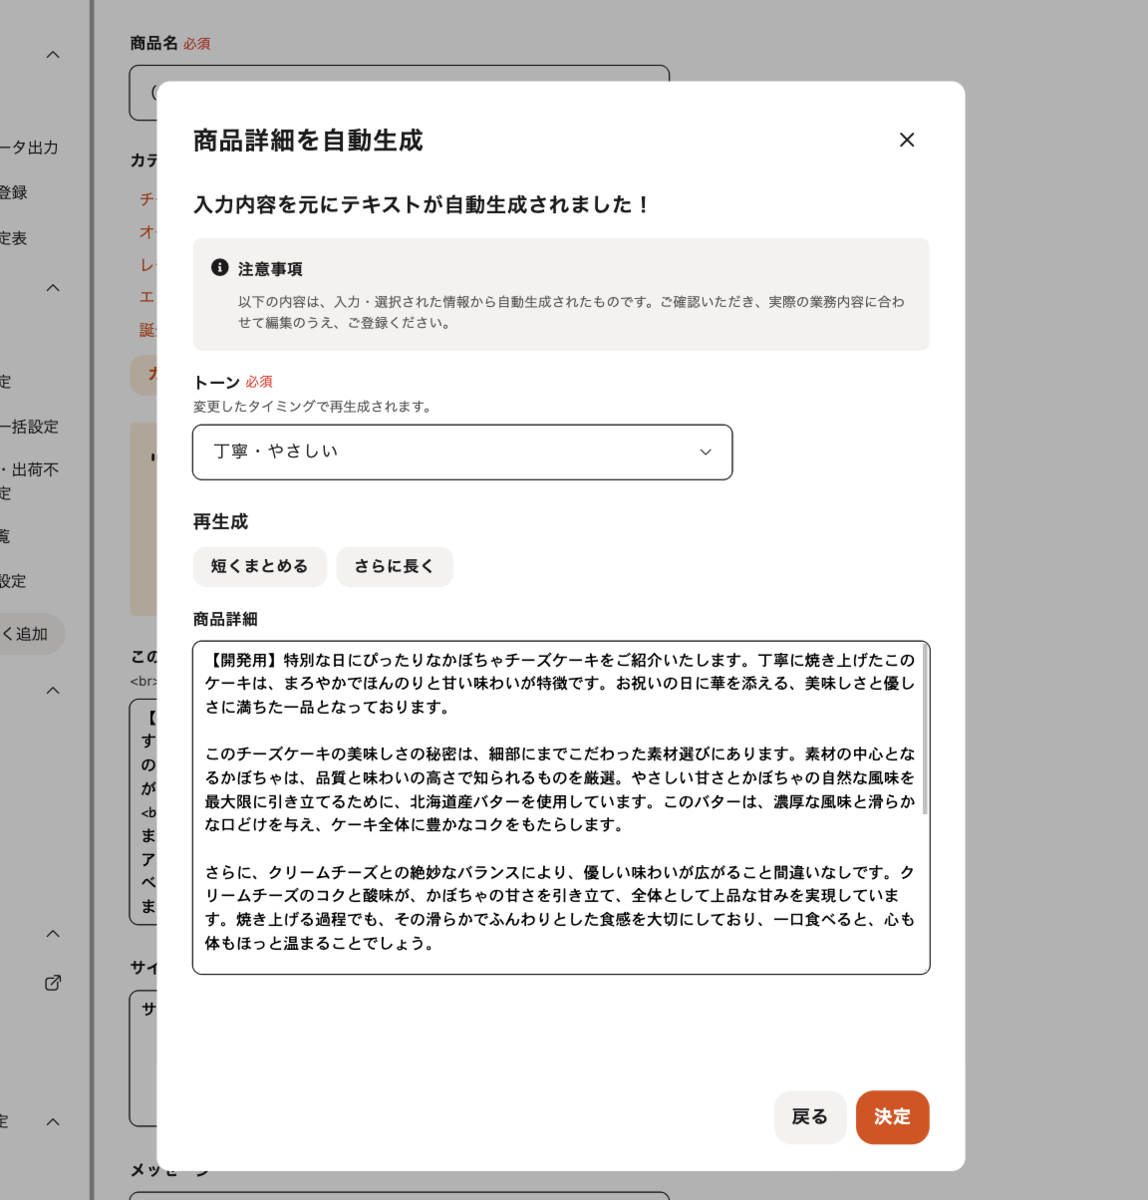
AIによって生成された説明文が、最後の画面のテキストエリアに表示されます。

ユーザーはその結果を見て自ら編集するのはもちろん、トーン変更や文章の長さ調整を再びAIにリクエストして再生成することもできます。

納得いく文章ができたら「決定」ボタンで、商品登録フォームに上書き反映される仕組みです。

生成AIならではの待ち時間のUX

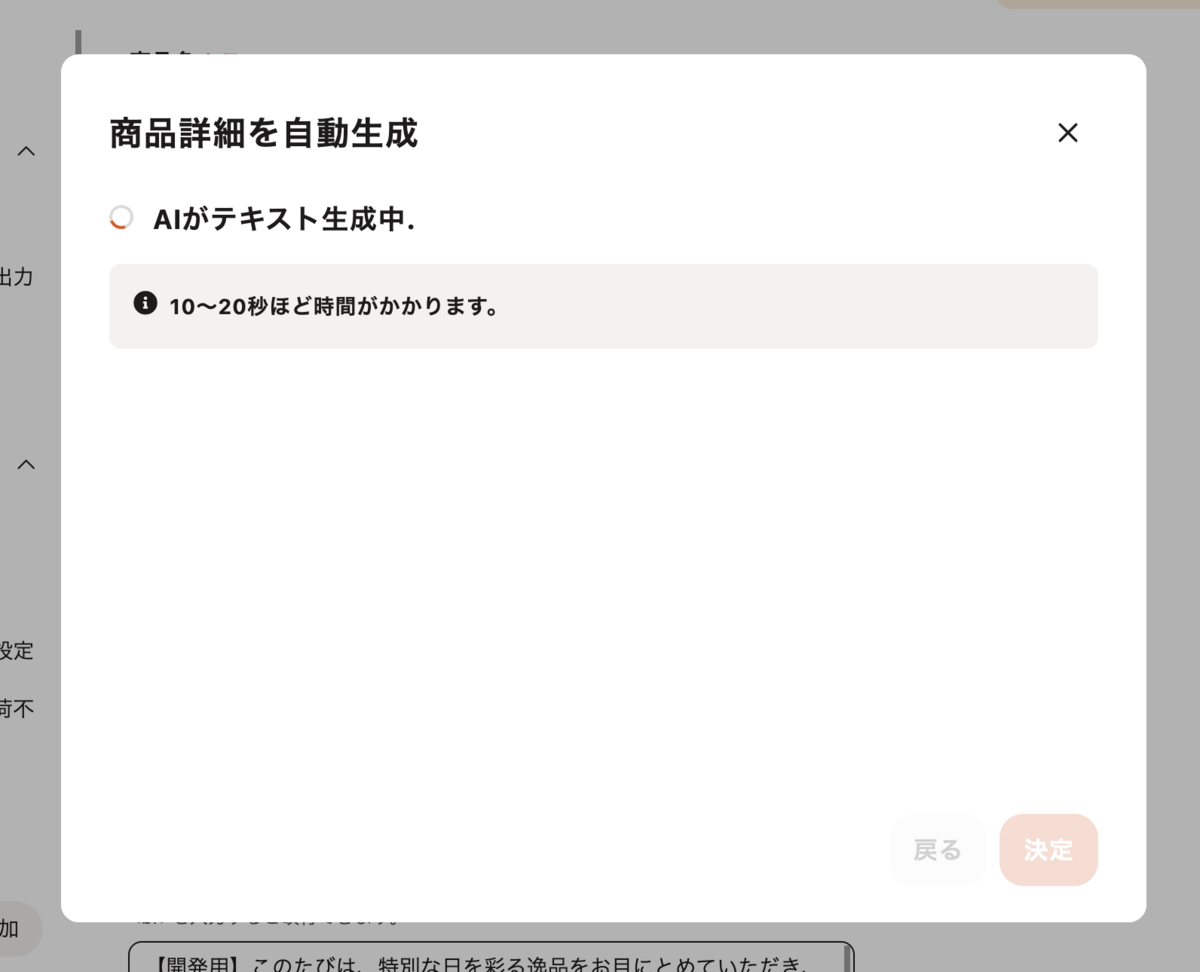
今回はストリーミングでの受信ではなく、すべての結果が生成されてから画面に反映する仕様にしたので、生成中は何も変化がない待ち時間が発生してしまいました。 (Difyではresponse_mode = 'blocking' というモード)

応答時間はモデルやプロンプトによってかなり差異が出るのですが、今回私たちが設定した環境では10秒〜20秒ほどかかることが分かりました。

AI生成時代のお気軽【思考アニメーション】

体感的にも少し長めに待たされるので、一般的にローディングでよく使われるクルクル回るスピナーのみでは荷が重いと感じました笑

そこで、3点リーダー点滅アニメーション を追加で採用しました。
☝️「AIがテキスト生成中」のあとにつづく ... がひとつひとつ点滅アニメーションします。

これには次のような利点があります。

  • デザインする必要がない
  • 画像や素材を用意しなくてよい
  • 表示エリアも最小限で済む
  • なにか思考している雰囲気を出せる

ミニマムで扱いやすいので、多くのAIアプリ系で採用されていますね。

とくに良い点は、いまの時代ではAIにアニメーションの生成を頼むとすぐにjsを実装してくれるところですね笑

タイプライティングの演出で生成感を出す

また、生成された文章をテキストフィールドに表示する際に、タイプライティングしているかのように1文字ずつ出現するアニメーションも実装しました。

ストリーミングモードでは当たり前の動作であったりしますが、今回の仕様ではレスポンスがあった時点で文章の全てがすでに存在しているので、本来は不要なはずの演出です。

しかし、生成AIが文章をひとつひとつ紡ぎ出している雰囲気に見せることで、体感的に結果に対する付加価値を高めることができます。

こちらのアニメーションもまた、AIによって一瞬で実装することができました。

6. プロンプト設計のこだわり

Difyに渡すプロンプトは、単なる「自由文生成」ではなく、明確なルール・制約の元で自然な日本語文章を生成する設計にこだわりました。

  • 文章執筆のプロであるロールを与える
  • 750〜800文字に収める  
  • 記号(!・☆など)は使わず、句読点のみ  
  • トーン別の文体テンプレートを分岐して設定  
  • アレルゲン情報がある場合は必ず明記  
  • 文章に自然さと訴求力を持たせること  

これにより、生成内容の品質と安定性を確保しています。

プロンプト例

あなたはスイーツ専門EC「cake.jp」に出店する店舗の代わりに、商品ページに掲載される見出し付きの商品説明文を執筆するプロフェッショナルです。

出店者が入力した商品情報と希望するトーンに応じて、商品の魅力を最大限に伝える文章を構成してください。

以下のルールに従い、**750文字以上800文字以内の日本語文章**を作成してください。 
※本文のみを出力してください。見出しや注釈、説明文以外の返答は不要です。

---

【出力ルール】
以下の条件をすべて厳守してください:
■商品説明文
- 全体で**750文字以上800文字以内**にしてください 
- 範囲外の文字数になった場合は、自動的に修正して再出力してください 
- 訴求力があり、読みやすさを意識した構成にしてください   
- 誤解を招く表現、過度な誇張、事実と異なる内容は避けてください
- トーンに合わせた文体・語彙を使用し、自然な文章として構成してください
- 記号(!・☆・→など)は使用せず、句読点のみで整えてください
- アレルゲン情報が指定されている場合は、必ず文末または自然な位置に「〇〇を含みます。アレルギーをお持ちの方はご注意ください。」などの注意文を丁寧に記載してください

---

【トーン別ルール】

指定される `トーン` に応じて、以下のような雰囲気・文体で構成してください:

- **丁寧・やさしい**  
 やわらかく親しみやすい語調。全世代に安心感を与えるトーン。

- **お祝い感を出す**  
 ポジティブで明るい語彙を中心に、贈り物やイベント用途にふさわしい華やかな印象を与える文体。

- **高級感・上質**  
 格式ある言葉選びと落ち着いた構成。製法・素材・余韻など「こだわり」を重視する語り口。

- **カジュアル・親しみやすい**  
 やや口語寄りで軽快な文体。日常に寄り添う表現を使い、ラフすぎない自然な文章に。

- **子ども向け・かわいい**  
 やさしく楽しい語感。見た目や遊び心を引き出す表現。短めのセンテンスでリズミカルに。

- **明るい雰囲気にする**  
 パッと気持ちが上がるような色・味・シーン表現を中心に構成。ワクワク感を演出する。

- **職人のこだわりを伝える**  
 製法・素材・時間へのこだわりや、手仕事の丁寧さに焦点をあて、説得力ある語りに。

---

【出力形式】 
*本文のみを出力してください。見出し・注釈は不要です。*

-----
本文の結果の最初に【開発用】とプレフィクスを必ずつけてください

Difyのエンドポイントも本番用と開発用で分けたので、それらをサクッと識別するために、開発用には生成結果にプレフィクスを付け足すようにプロンプトで指示しています。

つづいて、ユーザープロンプト

【入力情報】
- 商品カテゴリ:{{#genre#}}
- シーン:{{#scene#}}
- キーワード{{#keyword#}}
- トーン:{{#tone#}}

【追加のお願いプロンプト】
- {{#sys.query#}}

※本記事用に実際のプロンプトから少し修正しています。

今回はチャットのように対話して生成する想定ではなかったのもあり、システムプロンプトとユーザープロンプトをどう明確に分けるべきかは、あまり検証しきれていないです。

あと当たり前ですが、プロンプトの質によって出力される結果の質も変わりました。

エンジニアが最初にテスト的に書いたプロンプトより、現在のプロンプトの方が明らかに出力される文章の質が良くなったことを実感できました。

「AIの性能は使う人間の能力値によって大きく変わる」とはまさにこのことだなと感じました。

7. 社内の反応と今後の効果に期待

この機能はリリースされたばかりのため、店舗さまからの反応はこれからですが、社内では非常に良い反響がありました。

「おおお!」

「なんかすごいAIっぽい!」

「説明文で悩んでた店舗さん、絶対助かるよね」

など、普段の改善タスクリリースとはひと味違った、生成AIならではの“見えるインパクト“ が ありました。

8. 苦労した点:プロンプトとUXの奥深さ

デモ作成は1時間で完了するほど手軽だった一方で…

安定出力のためのプロンプト調整には非常に時間がかかりました

モデル・トーン・応答速度・料金のバランス取りが難しく、最適解探しは沼です。どこまで追求してもこれが最高だというゴールには辿り着きません笑 これはAIに限った話ではありませんよね。

加えて、「ロード中の演出」など、生成AI特有のUX設計にも苦労

瞬時に結果が返されない、変に期待値が上がる、など生成AI特有のユーザー体験を、既存のサービスに馴染ませるのは、実装そのものより難しい課題だと改めて感じました。

どんな結果が返ってくるかをユーザーに想像できるようにしないと使用してもらえないし、 その想像を超える結果を返せるかということもまた重要であったりします。

9. 今後の展望:商品説明だけにとどまらない可能性

今回は「商品説明文生成」のみの機能でしたが、以下のような領域へも今後展開予定です:

  • 商品写真の見せ方支援
  • 売上分析 × AIによる改善提案
  • SNS用テキスト生成
  • レビューやFAQの自動補完
  • 広告コピーやバナー文の自動生成

「少ない労力で最大限に伝える」ことができれば、店舗さまにもお客さまにも、また私たちプラットフォーム側にも大きな価値があると確信しています。

10. まとめ

Dify APIを活用することで、既存のEC管理画面に最小限の工数で生成AIの価値を取り込むことができました。

「AIだからできること」ではなく、「AIによって本来やりたかったことが楽に実現できる」——そんな未来がすでに始まっています。

今後もCake.jpでは店舗さまと一緒に、購入していただくお客様に“ハッピー”をお届けすべく、AIも活用してさらに加速していく予定です。

figma mcp でデザイン再現実装に取り組んでいる話

はじめまして。 フロントのUI実装・デザインを担当している島です。

「このデザインをMCP使って実装したい!」というニーズ、高まっていますね。
figma公式MCPサーバーも装備され、ますますその動きは進みそうです。

弊社でも、Github CopilotとFigma MCPを使いAI活用したデザインの再現実装に取り組んでいるのですが、

このデザインをMCP使って実装したい!

👇️実際の現場だと

(実装のコンテキストとワークフローを理解して、)
(既存コードがあればそれ使って、)
(新規で作る場合は再利用可能なかたちで、)
このデザインをMCP使って実装したい!

というふうに、楽しい話から難しいお題へと変化します。

対する私たちの取り組みをご紹介します。

1. デザインの再現性を高める

まずは、アウトプットの品質の担保です。

同じプロンプトを入れても、モデルやタイミングによって、出力されるコードは異なります。
また、LLMの学習データに依存するので、勝手にアレンジを加えてくるケースもあります。

そこで、

  • 「誰がやっても大体同じものが出来上がる」状態にする
  • とにかく忠実にデザインを起こしてもらう
  • そのためのルールを追加していく

というところをゴールにおくことにしました。

参考)モデルによる出力差の実験

プロンプト

下記のfigmaを見て、デザインを忠実に再現してください。
cssはFLOCSSのルールでお願いします。
https://www.figma.com/design/xxxx/xxxx?node-id=3809-126614&t=nlL5vCTQBqeLZuy4-1

結果

👆️これだと4-oが優秀に見えますがw、私個人ではClaude 3.7 Sonnet(当時) のアウトプット品質・レスポンスの感じが好きで、よく使っています。

2. 既存コードの再利用を求めない

次に、既存コードの再利用についてです。

今まで作ってきたスタイルシートは資産なので活用したいところですが、それを理解・活用してもらうには、命名規則やファイル構成などをAIに学習させる必要があります。
ところが、弊社のフロント開発事情は以下のような状況です・・

  • デザインシステムはあるが、ソースコード側にUIライブラリ集が存在しない
  • 長い運用の中で、時代によって異なる命名規則・パーツが参照されており、一元管理できていない状態である
  • viewとロジックが分離しており、横断的である(.php、.ctp、.css、.jsファイルで動作する)

「ここ見ておけばOK!」なリソースをぱっと渡せず、どうしようか..と頭を抱えました。

そこで、再利用を頑張る必要性について検討しました。

  • 既存の.ctpが、再利用性の高い作りになっているかというと、そうでもない(どちらかというと、ページごとに用意されている傾向が強い)
  • 異なる命名規則がすでに混在しているので、守るべき命名規則はあってないようなもの
  • 保守の観点でいえば、既存クラスに変更をかけられた場合、他画面への影響が測れない(レビュー時の負担が増える)

結果として、

  • 既存コードは使わずいったん新規で組ませる。将来的に、共存/統合をしていく
  • ただし、命名については既存コードとバッティングしないよう工夫する(後述)

という方針で進めることにしました。

3. 誰しもがわかるコードで組んでもらう

実際にやると、なかなか一発で思った通りのコードがあがってくることはないので、出力されたコードを調整する場面も出てきます。
また、最終的には人間のレビューを通すことになるので、職種問わず、スタイリング用のコードを理解できる必要があります。

そこで考えたのが、CSSフレームワークの採用です。

  • すでに整った公式ドキュメントがある→探せば直し方の検討がつく
  • AIに対しても、コーディングガイドラインとして参照させることができる
  • 既存コードとも共存できる

試しにtailwind4のコードのみで組む実験をしてみると、tailwindビギナーでも、プロンプトの指示のみで合格点まで再現できることがわかりました。

以前からユーティリティクラス欲しいと思うシーンもあったこともあり、これを機にtailwind4を導入することにしました。

現在tailwindに精通しているメンバーはいませんが、AIがベースを作れば、学習負荷を抑えつつ全員で使えるようになると思っています。

参考)tailwindのコードでアラートを組む実験

👆️すべてtailwindのユーティリティクラスで再現されています

参考)既存画面をtailwindのクラスで置換する実験

👆️すべてtailwind4のクラスで組み直してくれています。(スクショ撮りつつで、調整込で~10分くらい)

4. 再利用はやりながら

とはいえ、デザインの保守性や、デザインシステムの存在意義を考えると、やはり再利用性はほしいところです。

ここに関しては、

という道筋で、デザインシステムと連携したコンポーネントクラスを新たに作っていく予定です。

参考)ボタンコンポーネントを作る実験

以上、まさに進行中のAI活用について、現場からご報告でした。
また進捗・成果が出てきたら、記事にしていきたいと思います。

余談

ちなみに、デザイン再現実装でfigma MCPを活用する場合、新規ページや単発系のページはとても相性が良いと思います。
(なぜなら他影響がなく、再利用性を考慮しなくてもよい、フリースタイル実装だから)

そういった部分活用に限って、業務フローに取り込んでみるのもおすすめです!

ご興味ある方は、ぜひ私たちと一緒に取り組みましょう。

Cake.jp開発チーム、GitHub Copilotを全員導入!DX推進の環境整備と開発効率化への挑戦

こんにちは、Cake.jp 技術部部長の中村です。


この度、Cake.jp技術部では、開発メンバー全員に GitHub Copilot を導入しました!

なぜ今、GitHub Copilotなのか

昨今生成AIの技術の進化には目を見張る物があり、Cake.jpでも生成AIを導入できないかを検討してきました。いろいろな生成AIがありますが、Cake.jpではチーム全体にGitHub Copilotを導入することに決めました。
以下の3点から、GitHub Copilotを導入することに決めました。

  1. 複数のモデルを選択できる
     GitHub Copilotは複数のモデルから開発に適したモデルを開発者自身が選択することができます。導入初期の段階では様々なモデルから自分たちに合致したモデルを探求するフェーズなので、そのニーズに最適でした。

  2. 様々なIDEで利用できる
     Cake.jpではPHPStorm(もちろん会社支給です!)やVSCodeといった、開発者が利用したいIDEで開発を行っています。GitHub Copilotは様々なIDEで利用できるため、Cake.jpの開発環境と合致していました。
  3. Cake.jpが掲げる「店舗DXの推進」のための、自らのDX実践
     Cake.jpではケーキ・スイーツ業界の「店舗DXの推進」をプロダクト戦略の大きな柱として掲げています。私たちが外部のお客様に対してDXを提案し、支援していく立場である以上、まずは私たち自身が最新の技術を積極的に活用し、最高の開発環境を整備することが不可欠だと考えています。
     これまで会社の開発環境として生成AIを利用する環境がなかったため、環境整備を行うことを決めました。

導入によって期待できる効果

GitHub Copilotを導入してまだ日は浅いですが、早くもいくつかの領域でその効果を実感したり、大きな期待を寄せながら検証を進めている利用シーンがあります。

  • テストコードの自動作成支援: 新しい機能開発や既存コードの改修において、テストコードの記述は不可欠です。しかし、弊社には10年以上運用しているシステムがあり、テストコードが整備されていない箇所も少なくありません。Copilotがコードの文脈を理解し、適切なテストコードの雛形や実装パターンを提案してくれるため、テストカバレッジの向上と開発スピードアップに繋がると期待しています。

  • レガシーコードのリファクタリング支援: Cake.jpのコードベースには、PHP 5時代から続く部分も存在しています。現在のPHPバージョンやモダンな設計パターンに最適化されていない箇所が多数残っています。Copilotのサポートを受けながら、安全に最適化を行うことが期待できます。

  • プルリクエスト(PR)レビューの効率化: Cake.jpでは一定の品質担保のため、リリース前のPRのレビューを必須としています。Copilotがコードの意図を読み解いたり、潜在的なバグや改善点をサジェストしてくれることで、レビュー前にセルフレビューを行うことができるようになりました。レビュー担当者の負担を軽減し、より本質的な議論や設計に関するレビューに時間をかけられるようになる期待があります。

  • レビューコメント作成時の壁打ち相手: レビューコメントを書く際に、「もっと良い表現はないか?」「この指摘は的確か?」と迷うことがあります。そんな時にCopilotに状況を説明し、コメント案を壁打ちすることで、より分かりやすく、建設的なレビューコメントを作成するのに役立つか検証を進めています。

これから

GitHub Copilotの導入をし、メンバーそれぞれが生成AIを活用したコード開発の検証をはじめてくれました。Cake.jpでは小話会という業務や業務外で得た知見をチームに共有する場を定期的に設けていて、その場でいくつもの事例紹介が飛び交っています。


Cake.jp技術部では、新しい技術を取り入れながら、より良い開発体験とプロダクト価値向上を目指しています。もしご興味をお持ちいただけたら、ぜひ採用情報もご覧ください。

www.wantedly.com

イベントレポート|株式会社カウシェとMeetUPを共同開催しました

1/23(木)に「誰かと一緒に」を楽しむお買い物アプリ「カウシェ」を運営している、株式会社カウシェのバックエンドエンジニアの皆様と一緒に、「バックエンド10人未満スタートアップの、バックエンド開発事情MeetUP」を開催しました。


実施の経緯や、当日の様子をご紹介します。


## 実施の経緯

当社のエンジニアチームは、小話会(業務や自学から得た知見をシェアする)や輪読会を週次で実施するなど、チームで学ぶ文化があります。


「もっとエンジニアの方に私たちのサービスを知ってもらいたい、語らいたい」という想いのもと、チームを飛び出し、当社を知っていただきながら語らう機会を作ってしまおう!ということで、ミートアップを複数回開催してきました。


今回、カウシェさんに共催の提案を持ち掛けたのは、「toCサービスかつ同じ規模感のエンジニア組織のトライ&エラーを聞いてみたい!」と思ったからです。


共通項が多いからこそ、明日から使えるTipsをお互い持ち帰り、高め合うことができるのではと思い、お声がけさせていただきました。


## 当日の様子

両社エンジニアメンバーに加え、7名の参加者が会場に集まりました。

今回の会場は、サイバーセキュリティクラウドにご協力いただき、素敵なリフレッシュエリアで開催させていただきました!


ソファもあってくつろぎながらLTを聞きつつ、和気あいあいと交流するのにピッタリな会場。サイバーセキュリティクラウドさんありがとうございました!


スタートは、会場スポンサーLT。サイバーセキュリティクラウド広報の川崎さんより、企業やプロダクトについてご紹介いただきました。


続いてCake.jpとカウシェのエンジニアLTへ。


## LT前半タイム

①Cake.jpのエンジニアマネージャー中村から、「会員200万人のサービスを支える開発の裏側」についてお話しさせて頂きました。


少人数でスプリングあたりのタスク数が少ないにも関わらず、プランニングの時間がとても長かったという課題がありました。なぜその問題が発生して、今現在どういう取り組みをしているか紹介させていただきました。


②カウシェのエンジニア永井さんより「カウシェの開発者体験を支える3要素」をテーマにお話しいただきました。


カウシェの開発者体験を支える3要素として、1, 仕様書ベースの開発プロセス、2,E2EテストによるCI、3,安心のリリースプロセス、を挙げてくださいました。 あるプロジェクトに関わるすべての職種が共通の仕様書を元に議論されているのは、とても興味深く、会場からも反応がありました。E2E テストによる CI は、API 仕様ファーストのテスト駆動開発を実践されてらっしゃいました。安心のリリースプロセスについては、すごく丁寧にリグレッションテストをされているのが印象に残りました。


## MeetUP

前半のLT発表を終えて、ここで両社エンジニアと参加いただいた皆様との交流タイム。

この日はピザと飲み物をご用意しました。


さて乾杯~!

食事を囲みながら、それぞれが抱える業務の悩みや、エンジニアあるあるで盛り上がるなど、たくさんの交流が生まれていました!本当に盛り上がってましたね。


## LT後半タイム

会場が熱気に包まれたところで、LT後半戦!


③Cake.jpのエンジニア釘野より、「小分けプルリクでコードレビュー」をテーマにお話しさせていただきました。


小さなチームによる開発であるからこそ、各自がやっている作業・プロダクトに対する知見の共有が課題であり、コードレビューが大事になります。そのコードレビューはとても面倒な作業であるのですが、レビュー範囲を小さくすることでのメリットがあること、起こり得るデメリットへの対策などを語りました。


④つづいて、カウシェのエンジニア高橋さんより「カウシェのエラー設計のお話」をご紹介いただきました。


執筆されていた”エラーメッセージに仕様を書く!?” という記事を元にお話しいただきました。エラーメッセージを詳細に記述することで、問題を素早く理解し解決できるようにしていらっしゃることが印象に残りました。具体的なエラーメッセージを付けることで、問題の追跡が容易になることはとても良いエラー設計だなと思います。


⑤カウシェチームからは最後のLT!

カウシェエンジニアマネージャーの市島さんからは「スモールチームのための、ベストな業務委託との出会い方」についてお話しいただきました。


スモールチームに適した業務委託メンバーとの関係構築について説明いただきました。業務委託メンバーを「リソース補完」や「タスク消化」の視点ではなく、「チームの重要なパートナー」として関与してもらうというのは、とても興味深かったです。そのためには、チーム開発への理解、当事者意識、メンバーシップの3つの観点が重要であり、特に具体的な経験を引き出す質問や、失敗経験からの学びを重視することで適切なパートナーを見極めることができるとお話しいただきました。


⑥そして本日ラストのLT!

Cake.jpエンジニアの山内から「動的型付け言語に抗うPHPStanという戦士」というテーマでお話しさせていただきました。


レガシーコードの改善は、思わぬ不具合があります。そういった不具合を検知するすべが、手動での動作確認以外にありませんでした(ユニットテストが存在しない部分が多い)。その状況を打破すべく、PHPStanの導入を進めていった話をしました。


## MeetUP後半のようす

Cake.jpで販売中の人気ケーキ2つをご用意し、皆さんにも召し上がっていただきました。

甘いものがお好きな方が多く、喜んでいただけて嬉しかったです。


【ご用意したケーキ】

1.まるごとメロンケーキ

メロンをまるまる1個使用した贅沢なケーキ。メロンをカットすると中からきれいな断面のケーキが現れるサプライズにもぴったりな逸品です。

この日もカットすると、「おぉ~!!」と盛り上がっていました。


2.写真ケーキ

お好きな画像や写真をケーキにプリントでき、オリジナルケーキがつくれるCake.jpで人気のケーキです。この日ご用意したのは、イベントのキービジュアルを印刷したチョコレートケーキ。「印刷がとてもきれい!」と皆さん驚いていました。


終始なごやかな雰囲気で、Cake.jp・カウシェ両社のエンジニアに業務や組織環境のお話しを聞いてくださったり、メンバーの実際の働き方についてリアルな話なども交えて交流を楽しむことができました。また、参加者同士でのコミュニケーションもたくさん生まれ、この場をきっかけに新たなご縁ができたのではないかと思います。


## まとめ

今回初めて、共催という形でイベントを開催しました。

カウシェの皆さんと、イベントのタイトル決めや、当日のタイムスケジュール、告知など、両社で話し合い協力しながら開催することができ、単独で実施するよりも内容の濃いイベントになったのではないかと思います。


ご参加いただいた皆様からも「今まさに少人数で開発しているので興味があった」「GOとPHPの両方を使ったことがあったため」「スタートアップの開発組織について聞いてみたかった」と、今回のイベントテーマに共感いただいたようです。


今後もCake.jpではエンジニアの皆さまとの知見共有ができるLT会を行っていく予定です。

また、一緒に企画してくださる企業様も募集しています!


次回の開催告知も引き続きCake.jpのConnpassページより行います。ぜひフォローしていただけると嬉しいです!

毎週金曜日夕方に行われる脆弱性対応の会について

Cake.jp技術部の山内です。

みなさん、セキュリティ対策してますか?

新しいコードはある程度気をつけていても、古いコードに脆弱性が残っていたりはしませんか?

優先度が上げられず、脆弱性が残り続けていませんか?

・・・。

弊社がどうなのかはあえて明言しませんが、上記の状況を打破すべく(ほぼ言っている)、有志にて金曜日の17時から脆弱性対応という会を行なっています。

2024/05から現在(2024/11時点)まで、約半年ほど行なっています。

本日はその会について話していきます。

会の目的

会を行う目的は、大きく2つあります。

  • 脆弱性のある箇所を減らす
  • セキュリティ意識を上げる

ここについては狙い通り進められていると思います。

後者の「セキュリティ意識を上げる」は、レビューでの指摘などを通して、参加者に限らず全体に広がっていっているように感じます。

セキュリティへの意識が上がったことをキッカケに、2024/07~2024/10にかけて『Webブラウザセキュリティ ― Webアプリケーションの安全性を支える仕組みを整理する』という書籍を輪読会で読んだことも、意識向上につながっていると思います。

会の流れ

この会をどのように進めているかについてですが、一人がドライバーになり、他の人はそれを見つつ意見を言う、モブプロ形式で行なっています。

ドライバーは日毎に固定で、ツールはSlackのハドルを使用して、画面共有をしています。

対応する内容は、「対応したいことリスト」が存在するので、そこから選んで対応します。

対応完了したものは、翌月曜日にリリースしています。

対応したこと

色々と対応してきていますが、主には以下を潰していっています。

SQLインジェクション対策は、実際に攻撃する穴があってそれを塞いでいるというよりは、そういったアクセスがあった時点でブロックするような対応を行っています。現在まで何週にもわたって対応を続けています。

他には、脆弱性対応の会と言いつつも直近で発生した不具合を調査したり、問い合わせの調査をしたりということも行っており、柔軟に対応することを決めています。

発見経路の一例

前述した内容を対応するには、それらを発見する必要があります。

脆弱性診断を受け発見された例もありますが、それ以外を一つ紹介します。

弊社では開発言語としてPHPを使用しており、現在使用しているバージョンは8.3です。

1年半前までは5.6で、この1年半で少しずつバージョンを上げてきました。

バージョンが上がるごとに言語としての厳格さが増してきており、それに伴って今まではエラーにならなかったものがエラーになるようになっていきました。

そのエラーを調べてみると攻撃を受けていた、というケースもあり発見に至りました。

そういったものも、この会で対応していっています。

効果

対応したことであげたSQLインジェクション対策の効果について触れていきます。

(XSSとファイルアップロードの脆弱性については、そこを攻撃されたという記録はなく「塞いだ!」としか言えないので、、、)


まず前提として、弊社ではWAFを導入しています。

しかしWAFをすり抜けてくる攻撃が少なくありません。

(SQLエスケープしているので、データベース改ざんなどの被害はありませんが)

それがアプリケーションサーバやデータベースサーバの負荷が上がる原因になっていました。


SQLインジェクション対策によって、攻撃がアプリケーションに到達しにくくなり、攻撃があっても、アプリケーションサーバやデータベースサーバの負荷が上がりにくくなりました。

おかげで、休日に攻撃を受けて攻撃者をブロックする、という回数が激減して嬉しい限りです。

今後について

会の拡充はそこまで考えていません。

今は、「週の終わりにそこまで気張らず」というような雰囲気でやっています。

継続的にやれている一つの要因ではあると思っています。

このまま続けていって、少しでも堅牢なサービスを目指して続けていければと思います。

引き続きセキュリティ意識を高めていって、「セキュリティ意識高い系」な開発組織になっていければと思います。